| 论文链接 | 作用 | 发现的问题 | 发表时间 |
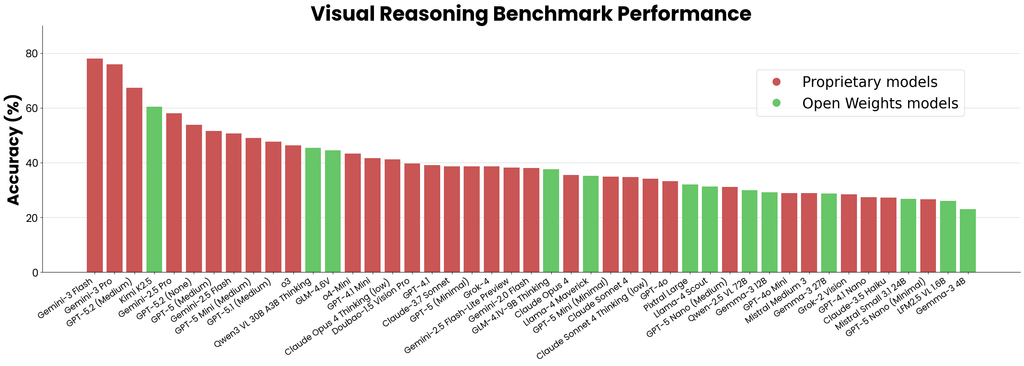
| https://arxiv.org/pdf/2602.12196 | 评估MLLM在基础教育学段,真实场景的Visual Problems; | (1)spatial ceiling,即在空间问题上的表现效果不好 | 2026/02 |
这篇论文的重点是在说作者自己为什么要提出这个benchmark,原因有:
(1)当前的MLLM的推理能力差,需要使用一个benchmark来衡量;
(2)当前已有的benchmark均不是立足真实的小学教育评估情景。比如:ARC/MM-IQ 这类人工构造的谜题,单独考察抽象能力,却缺乏教学相关性;Math-visa 这类竞赛题考察的高阶数学推理(文字),反映的是我专门的学术情景,而非基础学习。
MLLM推理主要集中在三大方面:
- Synthetic abstract Reasoning
- Academic Mathmetical Reasoning
- Research-Focused Visual Reasoning
1,Synthetic Abstract Reasoning
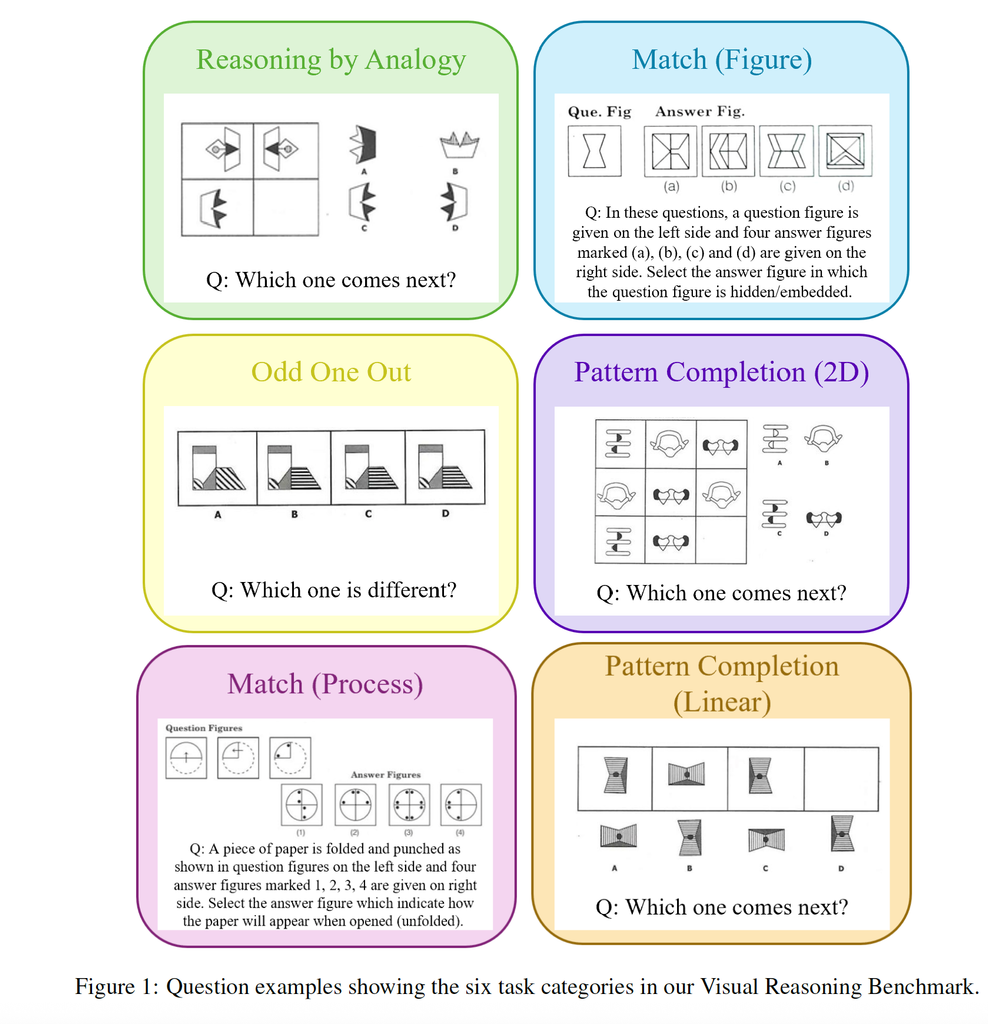
典型case就是:找规律的题
2,Academic Mathematical Reasoning
3,Research-Focused Visual Reasoning
以研究为导向的VR。
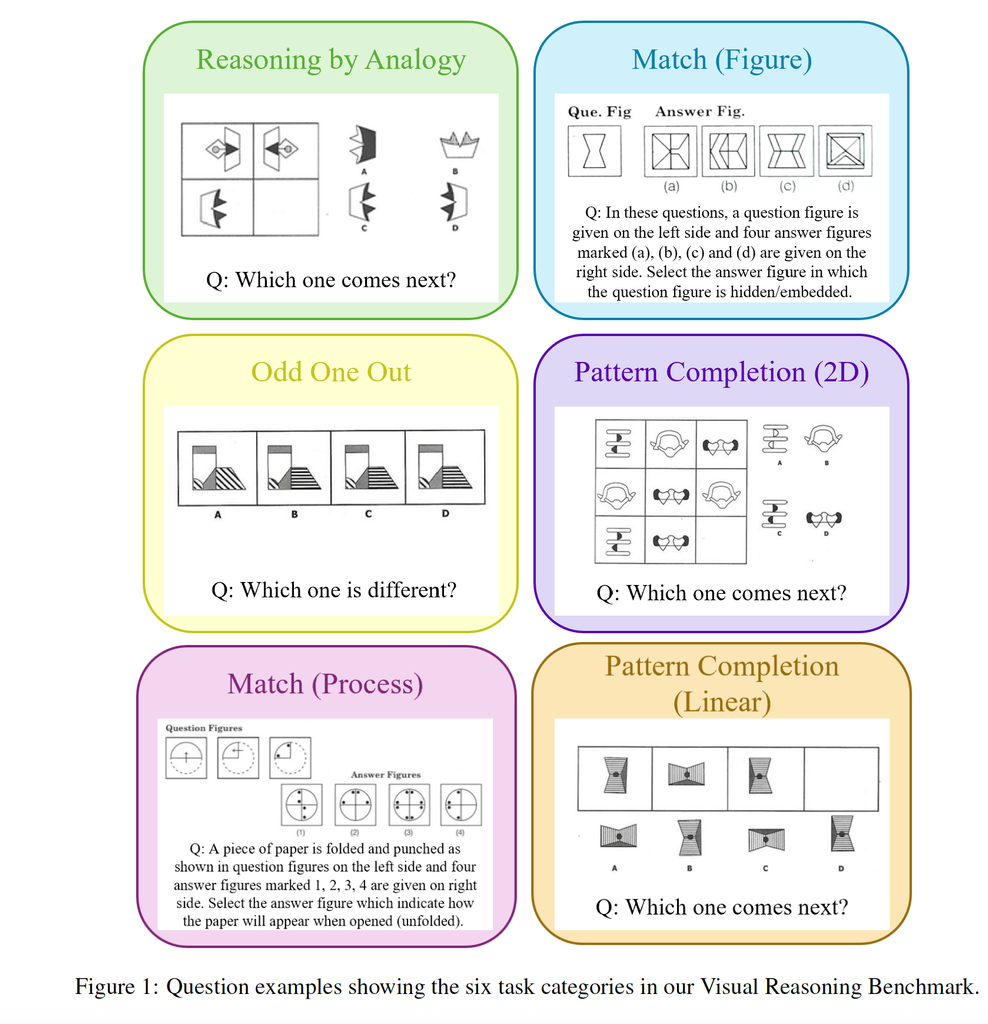
数据集中的case
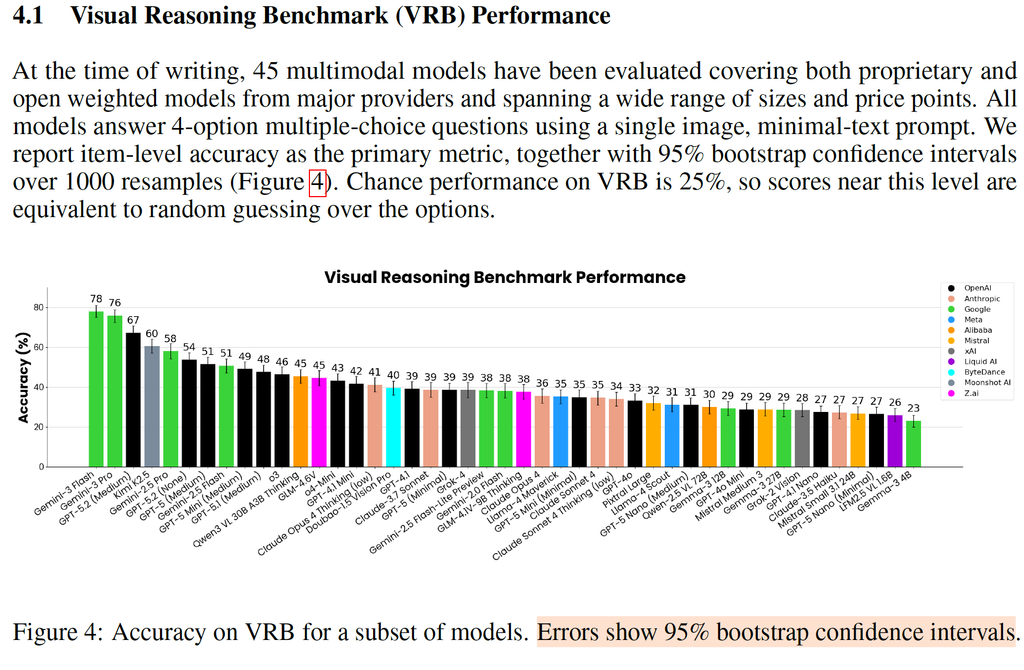
各大模型在 VRB 上的效果
发表回复